一次生成 30 条标题:模板 + 词库 + 过滤,先不花钱
把选题拆成人群、痛点、结果、形式四类词组,用几十行 Node 代码组合出候选标题,再按字数、关键词和绝对化用语过滤,最后导出 CSV 由你人工挑。
本页目录
30 秒速查
- 词库分四类:人群、痛点、结果、形式
- 模板 5 个左右,
seed固定,结果可复现- 过滤长度、关键词、违禁词、重复
- 跑
node generate.mjs,从 10 条里挑 3 条
这篇教程解决什么问题
选题有了,卡在标题。打开对话框让 AI 想 30 条,出来一半是“震惊”“必看”“99% 的人不知道”,另一半读起来像同一个模子。
更麻烦的是,你没法解释为什么留下这 5 条——下次还是从零开始。
这篇换一种做法:把标题拆成可组合的零件,先用规则穷举,再人工挑。好处是零成本、结果可复现、每条都能说出它是怎么来的。AI 留到第二步,只负责润色你挑中的那几条。
标题的四个零件
绝大多数可复制的标题,都能拆成四类信息:
| 零件 | 作用 | 例子 |
|---|---|---|
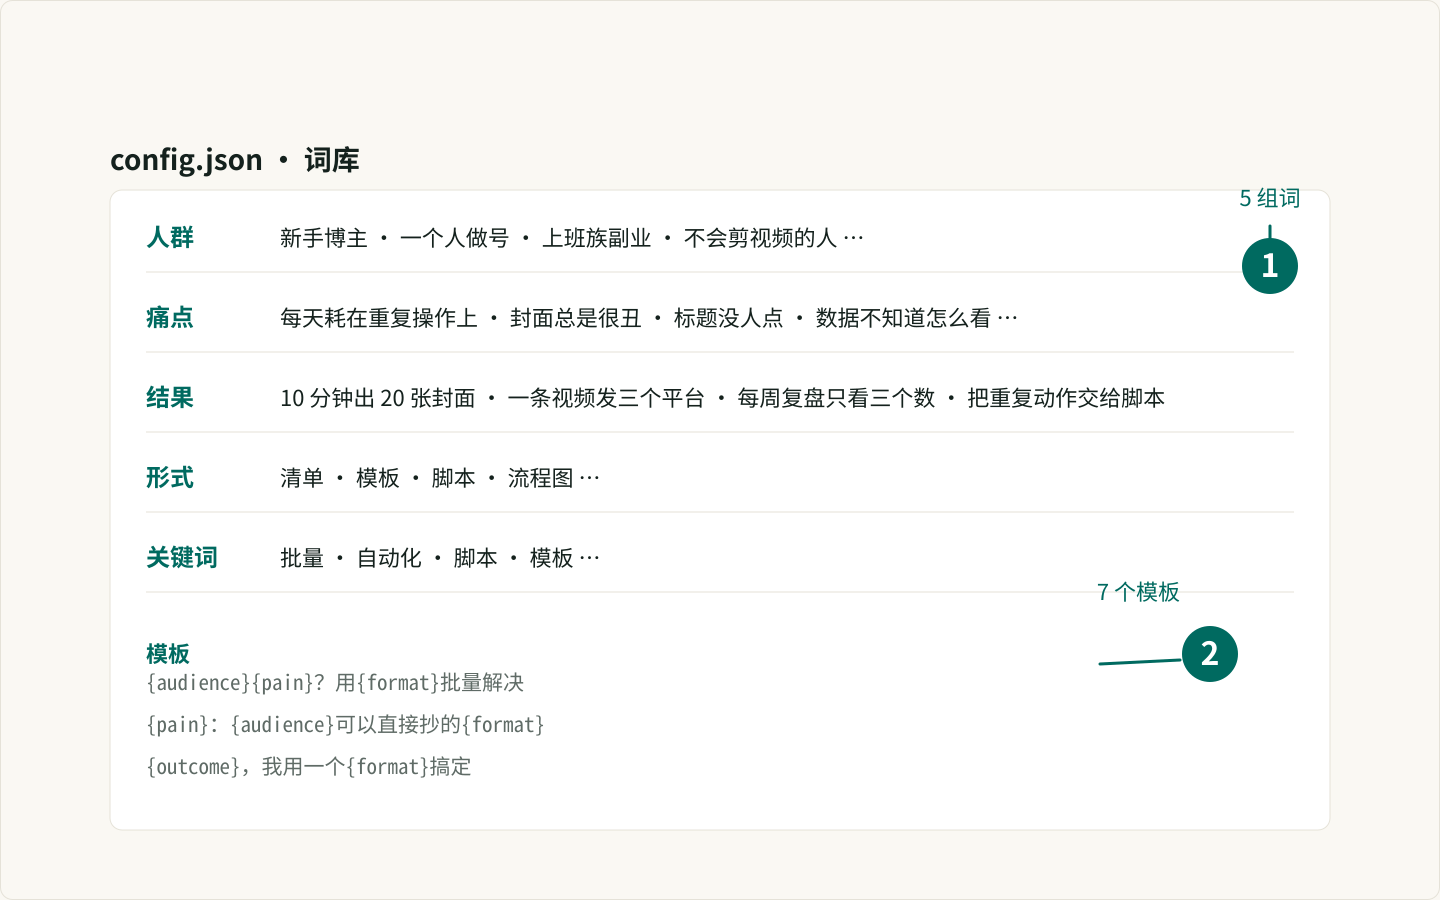
| 人群 | 让目标读者认领 | 新手博主、一个人做号 |
| 痛点 | 说出现在的问题 | 封面总是很丑、三个平台来回切 |
| 结果 | 承诺一个具体变化 | 10 分钟出 20 张封面 |
| 形式 | 说明交付物 | 清单、模板、脚本、工作流 |
再加一个关键词,让标题里稳定出现能被搜索和识别的词,比如“批量”“自动化”“模板”。
这五类词分别列在配置里。词库不需要一次写全,跑几轮后把无效的词删掉、把读者原话加进去,效果会越来越准。
目录结构
title-batch/
├── config.json
├── generate.mjs
└── out/
    ├── titles.csv
    └── shortlist.md
完整版本在 scripts/title-batch/,只用 Node 内置模块,不需要安装依赖。
写配置
{
  "count": 30,
  "seed": 20261024,
  "minLength": 10,
  "maxLength": 24,
  "audience": ["新手博主", "一个人做号", "上班族副业", "不会剪视频的人", "小团队运营"],
  "pain": ["每天耗在重复操作上", "封面总是很丑", "标题没人点", "数据不知道怎么看", "三个平台来回切"],
  "outcome": ["10 分钟出 20 张封面", "一条视频发三个平台", "每周复盘只看三个数", "把重复动作交给脚本"],
  "format": ["清单", "模板", "脚本", "流程图", "工作流"],
  "keywords": ["批量", "自动化", "脚本", "模板", "免费工具"],
  "patterns": [
    "{audience}{pain}?用{format}批量解决",
    "{pain}:{audience}可以直接抄的{format}",
    "{outcome},我用一个{format}搞定",
    "{audience}学{keyword},先避开这 3 个坑",
    "{pain}?我把它交给了{format}",
    "{keyword}入门:{audience}的一份{format}",
    "{outcome}?{keyword}其实没那么难"
  ],
  "maxPerPattern": 6,
  "banned": ["最好的", "最强", "最快", "最高", "第一", "100%", "绝对", "保证", "永久", "稳赚", "零风险", "必看", "必学"]
}
几个字段的作用:
seed固定随机序列。同样的词库和 seed,每次跑出来的 30 条完全一样,方便复盘“为什么当时没选它”。patterns里的{slot}会被随机填词。模板不要写太多,五个左右就够,多了会稀释差异。banned是发布前的合规底线。《广告法》禁止“国家级”“最高级”“最佳”等绝对化用语,写成子串规则最省事。
完整脚本
generate.mjs 的全文如下——只用 Node 内置模块,不需要装依赖:
import { readFile, mkdir, writeFile } from "node:fs/promises";
import path from "node:path";
import { pathToFileURL } from "node:url";

const ROOT = import.meta.dirname;

// 固定 seed,保证同一份词库每次跑出来的候选一致,方便和同事或过去的自己对比。
export function mulberry32(seed) {
  return function random() {
    seed |= 0;
    seed = (seed + 0x6d2b79f5) | 0;
    let t = Math.imul(seed ^ (seed >>> 15), 1 | seed);
    t = (t + Math.imul(t ^ (t >>> 7), 61 | t)) ^ t;
    return ((t ^ (t >>> 14)) >>> 0) / 4294967296;
  };
}

export const lengthOf = (text) => [...text].length;
export const normalize = (text) =>
  text.replaceAll(/\s|[,。!?、:;“”"'’]/g, "");

const pick = (list, random) => list[Math.floor(random() * list.length)];

export function fill(pattern, config, random) {
  const slots = [...pattern.matchAll(/\{(\w+)\}/g)].map((match) => match[1]);
  const values = {};
  for (const slot of slots) {
    const pool = slot === "keyword" ? config.keywords : config[slot];
    if (!Array.isArray(pool) || pool.length === 0) {
      throw new Error(`模板里的 {${slot}} 在 config.json 中找不到对应数组`);
    }
    values[slot] = pick(pool, random);
  }
  return values;
}

export function render(pattern, values) {
  return pattern.replaceAll(/\{(\w+)\}/g, (_, slot) => values[slot]);
}

export function findBanned(title, config) {
  return config.banned.find((word) => title.includes(word)) ?? null;
}

export function score(title, config) {
  const length = lengthOf(title);
  const keyword = config.keywords.find((word) => title.includes(word));
  let value = 40;
  if (keyword) value += 25;
  value += Math.max(0, 15 - Math.abs(length - 18));
  if (/[??!!]/.test(title)) value += 5;
  if (/\d/.test(title)) value += 5;
  return { value, keyword: keyword ?? "" };
}

export function csvCell(value) {
  const text = String(value ?? "");
  return /[",\n]/.test(text) ? `"${text.replaceAll('"', '""')}"` : text;
}

export function generateTitles(config) {
  const random = mulberry32(config.seed);
  const seen = new Set();
  const candidates = [];
  const patternCount = new Map();
  const stats = {
    attempts: 0,
    duplicated: 0,
    rejectedPattern: 0,
    rejectedLength: 0,
    rejectedBanned: 0,
    rejectedKeyword: 0,
  };
  const maxAttempts = config.count * 2000;

  while (candidates.length < config.count && stats.attempts < maxAttempts) {
    stats.attempts += 1;
    const pattern = pick(config.patterns, random);

    // 同一个句式最多用几次,否则 30 条里会有一半读起来一样。
    if ((patternCount.get(pattern) ?? 0) >= config.maxPerPattern) {
      stats.rejectedPattern += 1;
      continue;
    }

    const values = fill(pattern, config, random);
    const title = render(pattern, values);
    const key = normalize(title);

    if (seen.has(key)) {
      stats.duplicated += 1;
      continue;
    }

    const length = lengthOf(title);
    if (length < config.minLength || length > config.maxLength) {
      stats.rejectedLength += 1;
      continue;
    }

    if (findBanned(title, config)) {
      stats.rejectedBanned += 1;
      continue;
    }

    if (!config.keywords.some((word) => title.includes(word))) {
      stats.rejectedKeyword += 1;
      continue;
    }

    seen.add(key);
    patternCount.set(pattern, (patternCount.get(pattern) ?? 0) + 1);
    const { value, keyword } = score(title, config);
    candidates.push({ title, length, score: value, keyword, pattern, ...values });
  }

  candidates.sort((a, b) => b.score - a.score || a.length - b.length);

  return { candidates, stats };
}

function pickShortlist(candidates) {
  // 精选用贪心方式限制每个句式最多 2 条,避免清单被同一种说法刷屏。
  const shortlist = [];
  const picked = new Map();
  for (const item of candidates) {
    if (shortlist.length >= 10) break;
    if ((picked.get(item.pattern) ?? 0) >= 2) continue;
    shortlist.push(item);
    picked.set(item.pattern, (picked.get(item.pattern) ?? 0) + 1);
  }
  return shortlist;
}

async function main() {
  const configPath = path.resolve(ROOT, process.argv[2] ?? "config.json");
  const config = JSON.parse(await readFile(configPath, "utf8"));
  const OUTPUT_DIR = path.join(ROOT, "out");

  const { candidates, stats } = generateTitles(config);

  await mkdir(OUTPUT_DIR, { recursive: true });

  const headers = ["title", "length", "score", "keyword"];
  const csv = [
    headers.join(","),
    ...candidates.map((item) => headers.map((header) => csvCell(item[header])).join(",")),
  ].join("\n");

  await writeFile(path.join(OUTPUT_DIR, "titles.csv"), `${csv}\n`);

  const shortlist = pickShortlist(candidates);
  const markdown = `# 标题候选(前 10 条)

共生成 ${candidates.length} 条,按分数排序。分数只做初筛,最终以你愿不愿意点开为准。

${shortlist
  .map(
    (item, index) =>
      `${index + 1}. **${item.title}**(${item.length} 字,${item.score} 分)\n   - 模板:\`${item.pattern}\``,
  )
  .join("\n")}

## 下一步

1. 从这 10 条里挑 3 条,改成你账号自己的语气。
2. 剩下的交给读者投票,或先各发一次小范围测试。
3. 被否掉的词回到 \`config.json\`,下次不再生成。
`;

  await writeFile(path.join(OUTPUT_DIR, "shortlist.md"), markdown);

  console.log(`已生成 ${candidates.length} 条标题`);
  console.log(`尝试 ${stats.attempts} 次;重复 ${stats.duplicated},句式配额 ${stats.rejectedPattern},超长/过短 ${stats.rejectedLength},违禁词 ${stats.rejectedBanned},缺少关键词 ${stats.rejectedKeyword}`);
  console.log(`结果:${path.relative(ROOT, path.join(OUTPUT_DIR, "titles.csv"))}、${path.relative(ROOT, path.join(OUTPUT_DIR, "shortlist.md"))}`);
}

if (import.meta.url === pathToFileURL(process.argv[1] ?? "").href) {
  await main();
}
它按顺序做五件事:读配置 → 用固定 seed 的随机函数按模板组合 → 过滤长度、关键词、违禁词和重复 → 按分数排序 → 导出全部候选和 10 条精选。
组合:按模板填槽
脚本里的 mulberry32(seed) 是个固定 seed 的随机函数,不用第三方库:同一个 seed 每次吐出同样的序列,所以“同样的词库 + seed,生成的 30 条完全一样”成立。
fill(pattern, config, random) 负责从模板里提取槽位并填词,render 再把 {slot} 换成具体的词。
如果某个槽位在配置里不存在,直接抛错。静默跳过会让模板悄悄失效,你只会觉得“最近生成的标题怎么都一样”。
过滤:长度、关键词、违禁词
generateTitles 里每条候选都要同时过四关:重复、长度、违禁词、关键词。
去重要先做标点归一化,否则“标题没人点?”和“标题没人点!”会被当成两条。长度用 lengthOf(也就是 [...title].length)而不是 .length,中文和 emoji 都能按字符数计算。
banned 用简单的 includes,会有误伤。比如把“第一”列进去,“第一份清单”也会被拦。这个取舍是故意的:宁可多拦,发布前你再人工放行,比漏掉一条违规表述安全。
排序:分数只用来初筛
生成出来的候选需要排序,但不要假装分数能代表“会不会爆”。score(title, config) 只用来把明显更合适的放前面。
规则很朴素:有搜索词、长度接近 18 字、带问句或数字的排在前面。它不判断内容好不好,只保证排序结果稳定、能解释。
控制同质化
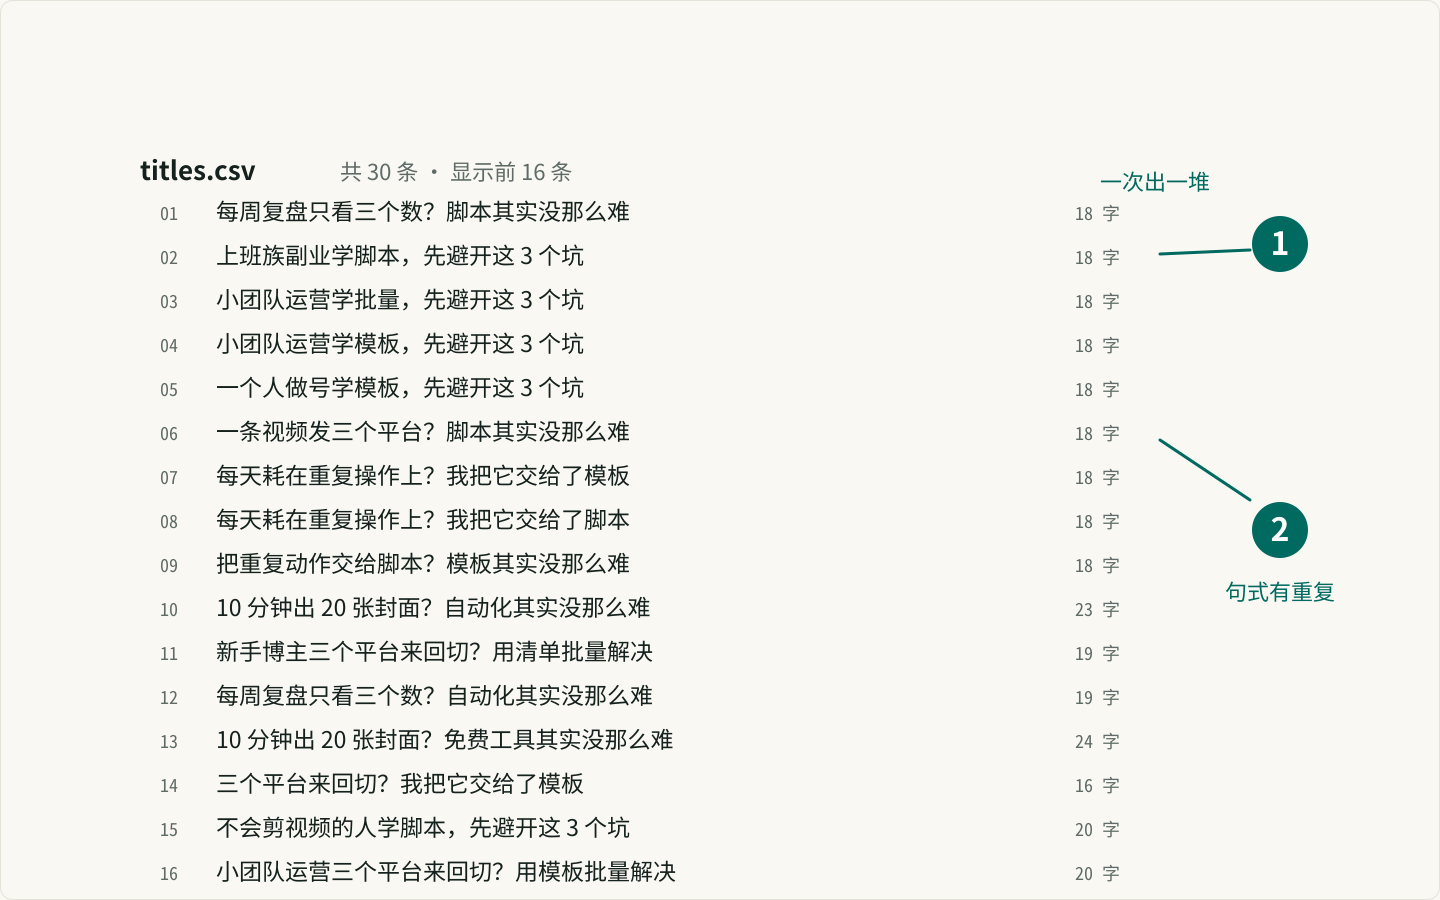
如果只做一次随机组合,30 条里会出现十几次同一个句式。两个地方要限制:
- 单句式配额:同一个模板最多产出
maxPerPattern条。 - 精选去重:最终清单里,每个模板最多出现 2 条。前者由
generateTitles的maxPerPattern管,后者由pickShortlist管。
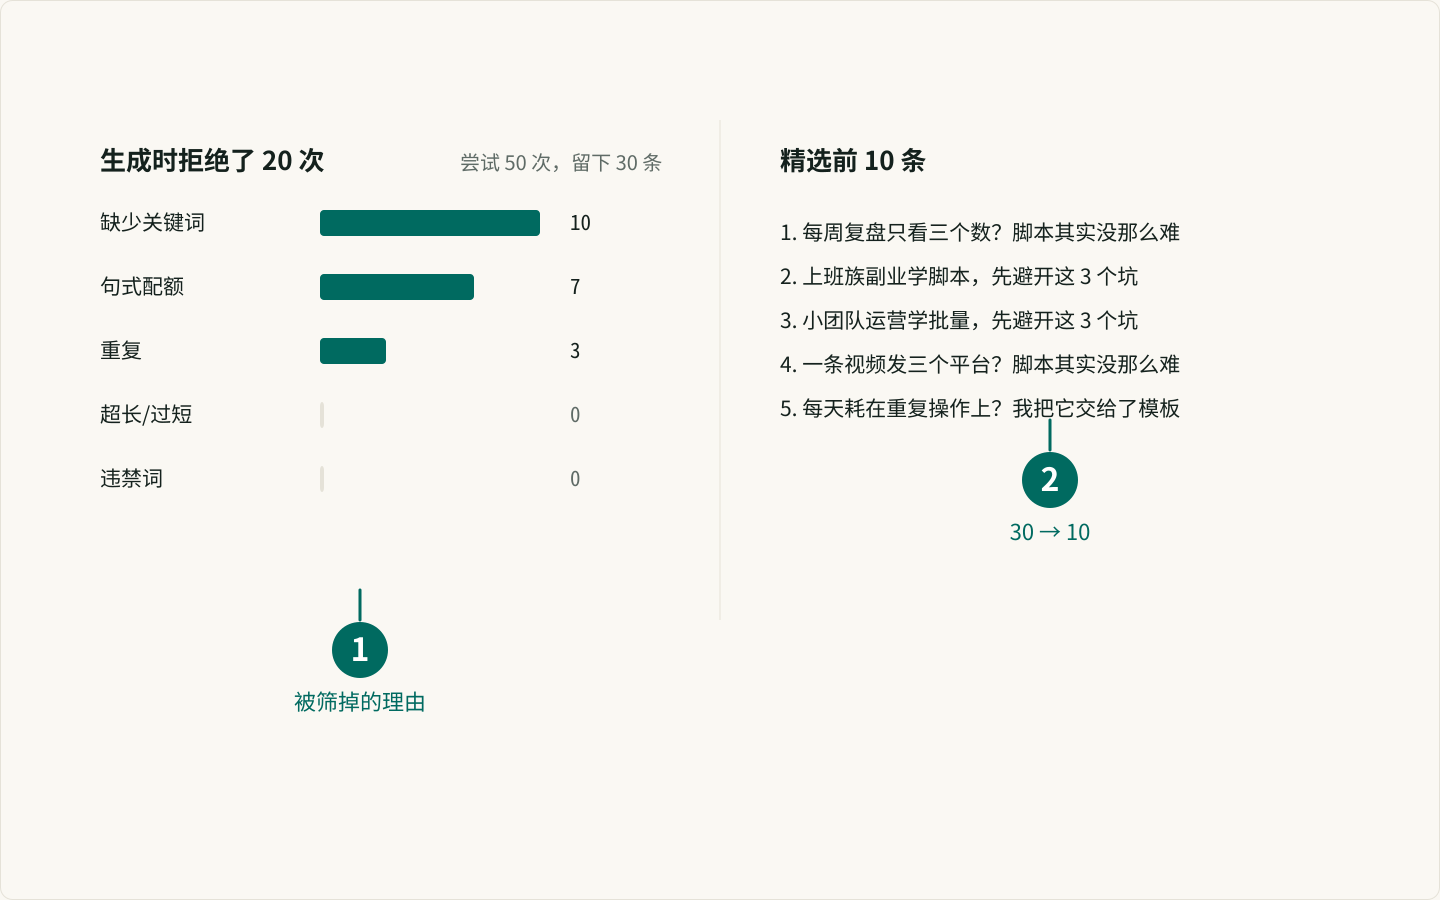
这样 titles.csv 保留全部 30 条供筛选,shortlist.md 只给你 10 条读起来不一样的。
运行
node generate.mjs输出大致如下:
# 标题候选(前 10 条)

1. **每周复盘只看三个数?脚本其实没那么难**(18 字,85 分)
   - 模板:`{outcome}?{keyword}其实没那么难`
2. **上班族副业学脚本,先避开这 3 个坑**(18 字,85 分)
   - 模板:`{audience}学{keyword},先避开这 3 个坑`
3. **一条视频发三个平台?脚本其实没那么难**(18 字,85 分)
   - 模板:`{outcome}?{keyword}其实没那么难`
4. **每天耗在重复操作上?我把它交给了模板**(18 字,85 分)
   - 模板:`{pain}?我把它交给了{format}`
5. **新手博主三个平台来回切?用清单批量解决**(19 字,84 分)
   - 模板:`{audience}{pain}?用{format}批量解决`
每条都带着模板来源。哪类句式你从来没选过,下次就从配置里删掉。
人工挑,而不是全收
从 10 条里挑 3 条,按这三个标准:
- 能不能用一句话说清交付物。 “学脚本,先避开这 3 个坑”比“脚本其实没那么难”更具体。
- 像不像你平时说话。 不像就改,改完读一遍。模板只负责结构,语气得你自己来。
- 有没有承诺过头。 标题里的数字和结果,正文必须兑现。
剩下的可以拿去做选题投票:把 5 条候选发到公众号或社群,让读者选下周写哪个。投票结果比任何“标题打分”都更接近真实需求。
可选:让 AI 只做润色
如果你已经在用 API,可以把 shortlist.md 里的 10 条喂给模型,要求它保持原意、只改语气、不新增事实。这样比让 AI 从零想 30 条更可控,也更省 token。
参考站内的 AI API 重试客户端,先保证批量调用不会因为一次 429 中断,再谈润色。
常见坑
1. 词库互相矛盾
“不会剪视频的人”配“剪一条要两小时”会读起来别扭。跑完先通读 10 条,把明显不搭的组合记下来,删词或改模板,不要指望过滤器解决语义问题。
2. 关键词堆砌
每条都必须含关键词,容易变成“批量脚本自动化模板”这种没有主语的标题。关键词保留一个就够,不要在一个标题里塞两个。
3. 直接批量发布
脚本能保证长度和格式,不能保证内容真实。标题承诺了“10 分钟出 20 张”,正文就得给出可复现的步骤和产物。标题的价值来自正文兑现,不是来自句式。
4. 平台字数变了
各平台规则会调整。把 minLength / maxLength 当成配置项,按主发平台改;同时发多个平台时,用最严格的限制生成,再按平台单独放宽。
常见问题
为什么不直接用 AI 生成标题?
可以,但先把不需要 AI 的部分做完。模板组合零成本、可解释、可复现;AI 更适合在候选里润色和改写。先穷举结构,再让 AI 加工,比直接让 AI 想 30 条更可控。
生成出来的标题会不会很套路?
会。它的定位是候选池,不是最终文案。脚本负责把结构穷举出来,你负责挑出 3 条改成自己的语气。完全交给脚本直接发布,内容会失去个人特征。
各平台的标题字数限制是多少?
小红书标题通常 20 字左右,抖音更长,公众号空间最大。脚本用 minLength / maxLength 统一控制,按主发平台设置即可;一稿多平台时建议取最严格的限制。
绝对化用语过滤会不会误伤?
会。“第一份”“最后一步”都可能被简单的子串匹配拦下。这正是为什么过滤词要写在配置里:发现误伤就把规则改精确,而不是关掉检查。
每周一张复习表
每周分享一张实用复习表,不收钱不打扰,想走随时走
邮箱存在 Cloudflare KV 里,只用来发每周更新;任何时候写信到hello@genwozuo.com说「退订」就删掉。详见隐私政策。