每周 10 分钟复盘:把三个平台后台导出的 CSV 拼成一张周报
不接 API、不装 BI。用一段 Node 脚本读小红书、公众号、抖音后台导出的 CSV,统一字段、算出互动率、标出异常,直接输出一份能看的 Markdown 周报。
本页目录
30 秒速查
- 三个平台各导出一份 CSV,放进
sample/- 在
config.json里把平台列名映射到曝光、互动- 跑
node review.mjs,看中位数和异常- 把下周动作写成具体条目,下周照着做
这篇教程解决什么问题
内容做了几周,数据散在三个后台:小红书看曝光和收藏,公众号看阅读和在看,抖音看播放和完播。每周想复盘一次,光是把数字抄进表格就要半小时,抄完还看不出结论。
更常见的情况是:看到一个高赞就兴奋,看到一个低播放就焦虑,但没有中位数做参照,不知道哪个才算真正的异常。
这篇的做法是:每个平台导出 CSV,脚本负责统一字段和算指标,你只负责解释异常和决定下周写什么。产物是一份 Markdown 周报和一份 JSON,后者可以直接积累成月度趋势。
先定三个指标
不要一上来就做十几列的看板。第一版只看三个数:
| 指标 | 算法 | 用来回答 |
|---|---|---|
| 曝光 | 各平台曝光/播放/阅读 | 内容有没有被分发出去 |
| 互动 | 点赞 + 评论 + 收藏 + 分享 | 看到的人有没有反应 |
| 互动率 | 互动 ÷ 曝光 | 内容本身留不留人 |
互动率比绝对互动数更有用,因为它把平台流量波动排除了一部分。但要注意两个边界:
- 曝光太低时互动率不稳定。 300 曝光里多 10 个赞就能改变排序,所以脚本只对曝光 ≥ 100 的内容计算排名。
- 平台口径不同。 抖音的“播放”和小红书的“曝光”不是一回事,公众号的“阅读”还包含历史文章入口。跨平台只看趋势,不要精确比大小。
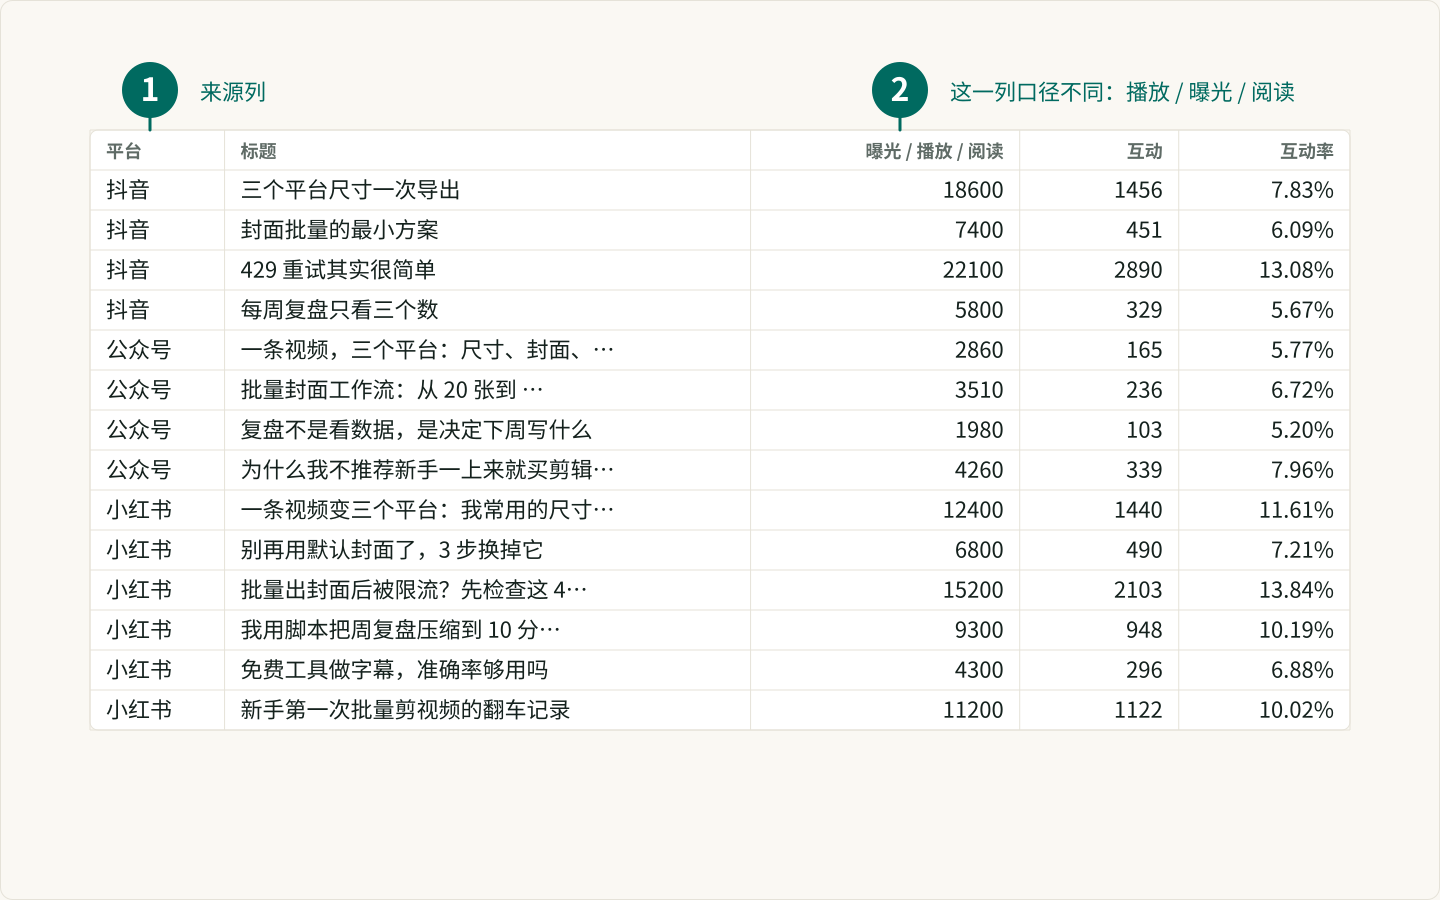
从后台导出 CSV
三个平台都有导出入口,位置会随版本调整,按后台实际菜单找即可:
- 小红书:创作中心 → 数据中心 → 内容分析,选择时间范围后导出。
- 公众号:后台 → 内容分析 → 图文分析,按文章导出或复制表格。
- 抖音:创作者服务中心 → 数据中心 → 作品数据,支持导出明细。
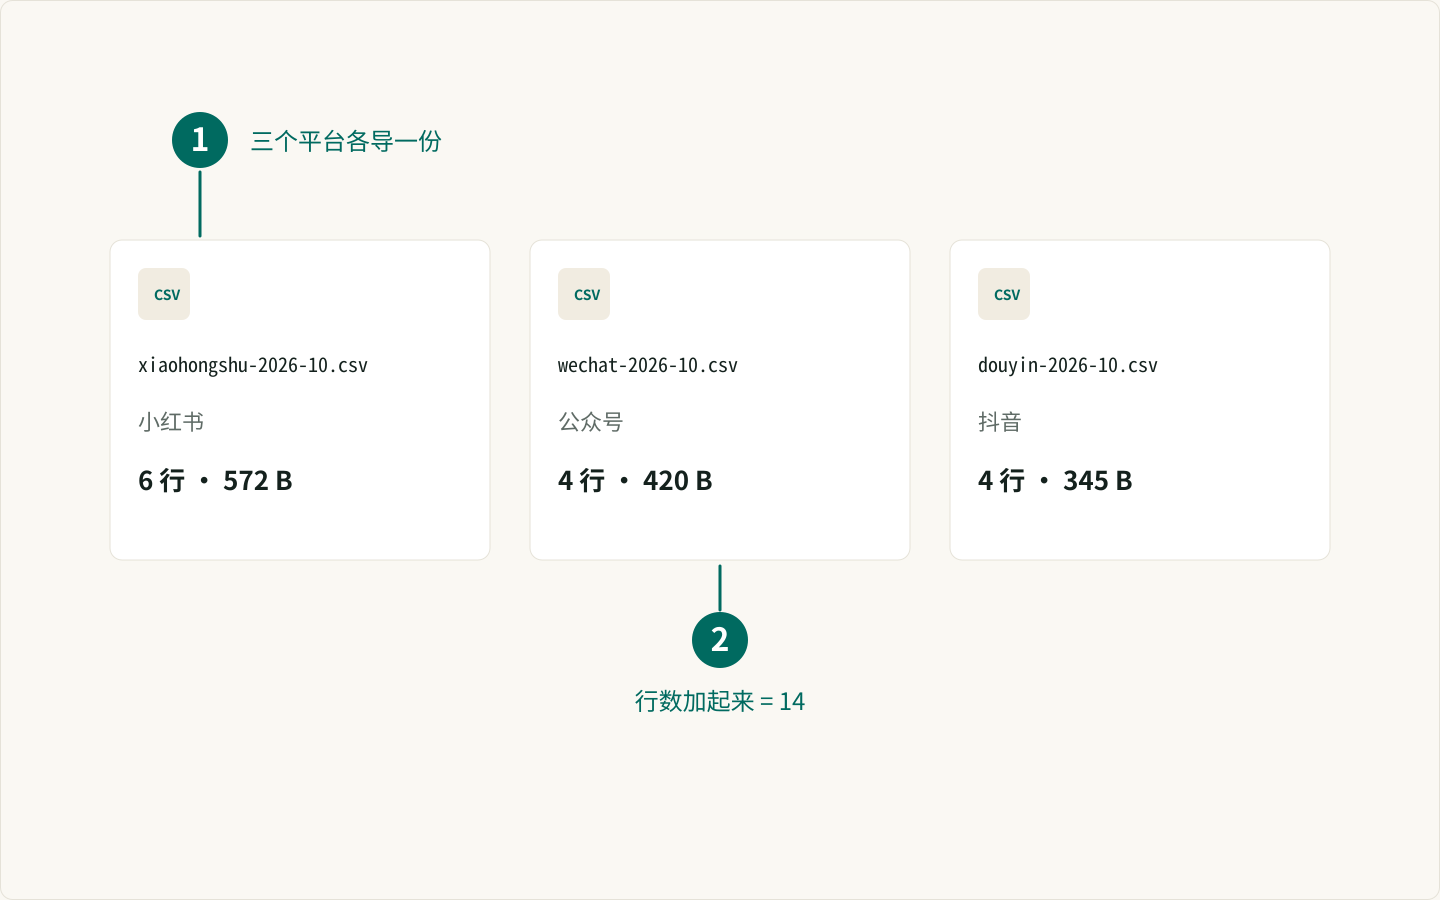
导出的列名每个平台都不一样,这正是最容易卡住的地方。不要手工改表头,把差异写进配置,以后换账号也不用重来。
目录结构
content-review/
├── config.json
├── review.mjs
├── sample/
│   ├── xiaohongshu-2026-10.csv
│   ├── wechat-2026-10.csv
│   └── douyin-2026-10.csv
└── out/            # 生成结果,加进 .gitignore
完整可运行版本在 scripts/content-review/。先把 sample/ 换成你自己的导出文件,跑通后再改配置。
用配置消化字段差异
config.json 做两件事:告诉脚本去哪个目录读文件,以及每个平台的列名映射到哪个指标。
{
  "inputDir": "sample",
  "outputDir": "out",
  "platforms": {
    "xiaohongshu": {
      "label": "小红书",
      "columns": {
        "title": "笔记标题",
        "date": "发布时间",
        "views": "曝光量",
        "likes": "点赞",
        "comments": "评论",
        "collects": "收藏",
        "shares": "分享"
      }
    },
    "wechat": {
      "label": "公众号",
      "columns": {
        "title": "标题",
        "date": "发表时间",
        "views": "阅读量",
        "likes": "点赞",
        "comments": "留言",
        "collects": "在看",
        "shares": "转发"
      }
    }
  }
}
平台 key 要和文件名前缀一致,比如 xiaohongshu-2026-10.csv。脚本先按文件名识别平台,识别不到再尝试用表头匹配,这样文件改名后不至于直接失败。
完整脚本
review.mjs 的全文如下——只用 Node 内置模块,不需要装任何依赖:
import { readdir, readFile, mkdir, writeFile } from "node:fs/promises";
import path from "node:path";
import { pathToFileURL } from "node:url";

const ROOT = import.meta.dirname;

// 平台后台导出的 CSV 常常带 BOM、CRLF 和引号包裹的逗号,先统一处理再按行切。
export function parseCsv(text) {
  const source = text.replace(/^/, "").replaceAll("\r\n", "\n");
  const rows = [];
  let row = [];
  let field = "";
  let quoted = false;

  for (let i = 0; i < source.length; i += 1) {
    const char = source[i];

    if (quoted) {
      if (char === '"' && source[i + 1] === '"') {
        field += '"';
        i += 1;
      } else if (char === '"') {
        quoted = false;
      } else {
        field += char;
      }
      continue;
    }

    if (char === '"') {
      quoted = true;
    } else if (char === ",") {
      row.push(field);
      field = "";
    } else if (char === "\n") {
      row.push(field);
      rows.push(row);
      row = [];
      field = "";
    } else {
      field += char;
    }
  }

  if (field !== "" || row.length > 0) {
    row.push(field);
    rows.push(row);
  }

  return rows.filter((line) => line.some((cell) => cell.trim() !== ""));
}

export function toNumber(value) {
  const number = Number(String(value ?? "").replaceAll(",", "").trim());
  return Number.isFinite(number) ? number : 0;
}

export function parseDate(value) {
  const text = String(value ?? "").trim().replaceAll("/", "-");
  const date = new Date(text.replace(" ", "T"));
  return Number.isNaN(date.valueOf()) ? null : date;
}

export function median(numbers) {
  if (numbers.length === 0) return 0;
  const sorted = [...numbers].sort((a, b) => a - b);
  const middle = Math.floor(sorted.length / 2);
  return sorted.length % 2 === 0
    ? (sorted[middle - 1] + sorted[middle]) / 2
    : sorted[middle];
}

export function percent(value) {
  return `${(value * 100).toFixed(2)}%`;
}

function pad(value) {
  return String(value).padStart(2, "0");
}

export function formatDate(date) {
  return date ? `${date.getFullYear()}-${pad(date.getMonth() + 1)}-${pad(date.getDate())}` : "未知";
}

export function detectPlatform(filename, header, config) {
  const byName = Object.entries(config.platforms).find(([key]) => filename.startsWith(key));
  if (byName) return byName[0];

  const byColumn = Object.entries(config.platforms).find(([, platform]) =>
    header.includes(platform.columns.title),
  );
  return byColumn?.[0] ?? null;
}

export function normalizeRow(row, header, platformKey, config) {
  const platform = config.platforms[platformKey];
  const pick = (column) => {
    const index = header.indexOf(column);
    return index === -1 ? "" : row[index];
  };

  const views = toNumber(pick(platform.columns.views));
  const likes = toNumber(pick(platform.columns.likes));
  const comments = toNumber(pick(platform.columns.comments));
  const collects = toNumber(pick(platform.columns.collects));
  const shares = toNumber(pick(platform.columns.shares));
  const engagements = likes + comments + collects + shares;

  return {
    platform: platform.label,
    title: String(pick(platform.columns.title)).trim(),
    date: parseDate(pick(platform.columns.date)),
    views,
    likes,
    comments,
    collects,
    shares,
    engagements,
    rate: views > 0 ? engagements / views : 0,
  };
}

export async function loadRows(inputDir, config) {
  const files = (await readdir(inputDir)).filter((file) => file.toLowerCase().endsWith(".csv"));
  const posts = [];
  const skipped = [];

  for (const file of files.sort()) {
    const rows = parseCsv(await readFile(path.join(inputDir, file), "utf8"));
    if (rows.length < 2) {
      skipped.push({ file, reason: "没有数据行" });
      continue;
    }

    const [header, ...body] = rows;
    const platformKey = detectPlatform(file, header, config);

    if (!platformKey) {
      skipped.push({ file, reason: "无法识别平台,请检查文件名或表头" });
      continue;
    }

    for (const row of body) {
      const post = normalizeRow(row, header, platformKey, config);
      if (post.title) posts.push(post);
    }
  }

  return { posts, skipped };
}

export function summarize(posts) {
  return {
    count: posts.length,
    views: posts.reduce((sum, post) => sum + post.views, 0),
    engagements: posts.reduce((sum, post) => sum + post.engagements, 0),
    rate:
      posts.reduce((sum, post) => sum + post.views, 0) > 0
        ? posts.reduce((sum, post) => sum + post.engagements, 0) /
          posts.reduce((sum, post) => sum + post.views, 0)
        : 0,
  };
}

export function buildMarkdown({ posts, skipped, range }) {
  const platforms = [...new Set(posts.map((post) => post.platform))];
  const overall = summarize(posts);
  const qualified = posts.filter((post) => post.views >= 100);
  const medianRate = median(qualified.map((post) => post.rate));
  const ranked = [...qualified].sort((a, b) => b.rate - a.rate);
  const best = ranked.slice(0, 3);
  const worst = ranked.slice(-3).reverse();
  const high = qualified.filter((post) => medianRate > 0 && post.rate >= medianRate * 1.8);
  const low = qualified.filter((post) => medianRate > 0 && post.rate <= medianRate * 0.5);

  const platformTable = [
    "| 平台 | 条数 | 曝光 | 互动 | 互动率 |",
    "| --- | ---: | ---: | ---: | ---: |",
    ...platforms.map((platform) => {
      const stats = summarize(posts.filter((post) => post.platform === platform));
      return `| ${platform} | ${stats.count} | ${stats.views} | ${stats.engagements} | ${percent(stats.rate)} |`;
    }),
    `| **合计** | ${overall.count} | ${overall.views} | ${overall.engagements} | ${percent(overall.rate)} |`,
  ].join("\n");

  const rankLines = (items) =>
    items.length === 0
      ? `暂无(有效样本不足 100 曝光)`
      : items
          .map(
            (post, index) =>
              `${index + 1}. **${post.title}**(${post.platform})— ${post.views} 曝光 / ${post.engagements} 互动 / ${percent(post.rate)}`,
          )
          .join("\n");

  const anomalies = [
    ...high.map((post) => `- 高于中位数 1.8 倍:**${post.title}**(${post.platform},${percent(post.rate)})`),
    ...low.map((post) => `- 低于中位数一半:**${post.title}**(${post.platform},${percent(post.rate)})`),
  ];

  const actions = [];
  if (best.length > 0) {
    actions.push(
      `把《${best[0].title}》拆成 2–3 个变体,下周同一时段再发一次,验证是选题有效还是时间有效。`,
    );
  }
  if (worst.length > 0) {
    actions.push(
      `回看《${worst[0].title}》的封面和前 3 秒:曝光有 ${worst[0].views},互动率只有 ${percent(worst[0].rate)},优先改钩子而不是改选题。`,
    );
  }
  if (platforms.length > 1 && ranked.length > 0) {
    const others = platforms.filter((platform) => platform !== best[0].platform);
    actions.push(
      `把表现最好的内容改写成 ${others.join("、")} 平台的尺寸和语气,复用素材而不是重新拍。`,
    );
  }
  if (platforms.length === 1) {
    actions.push("再接一个平台的数据:单平台看不出内容结构问题,只能看出平台问题。");
  }
  if (skipped.length > 0) {
    actions.push(`有 ${skipped.length} 个文件没读进来,先修字段映射,避免周报漏数据。`);
  }
  actions.push("从上面两条异常里各挑一条,写下你判断的原因,下周用一条新内容验证。");

  return `# 内容周报(${range})

> 共 ${overall.count} 条内容,覆盖 ${platforms.length} 个平台;曝光 ${overall.views},互动 ${overall.engagements},整体互动率 ${percent(overall.rate)}。

## 总览

${platformTable}

## 表现最好

${rankLines(best)}

## 需要复盘

${rankLines(worst)}

## 异常提醒

中位数互动率:${percent(medianRate)}(仅统计曝光 ≥ 100 的内容)

${anomalies.length > 0 ? anomalies.join("\n") : "本周没有明显异常。"}

## 下周动作

${actions.map((action) => `- ${action}`).join("\n")}
`;
}

async function main() {
  const configPath = path.resolve(ROOT, process.argv[2] ?? "config.json");
  const config = JSON.parse(await readFile(configPath, "utf8"));
  const inputDir = path.resolve(ROOT, config.inputDir);
  const outputDir = path.resolve(ROOT, config.outputDir);

  const { posts, skipped } = await loadRows(inputDir, config);

  if (posts.length === 0) {
    console.error(`没有从 ${inputDir} 读到任何内容,请检查 CSV 和 config.json 的字段映射。`);
    process.exit(1);
  }

  const dates = posts.map((post) => post.date).filter(Boolean).sort((a, b) => a - b);
  const range =
    dates.length > 0
      ? `${formatDate(dates[0])} ~ ${formatDate(dates.at(-1))}`
      : "日期缺失";
  const markdown = buildMarkdown({ posts, skipped, range });

  await mkdir(outputDir, { recursive: true });
  await writeFile(path.join(outputDir, "report.md"), markdown);
  await writeFile(
    path.join(outputDir, "report.json"),
    JSON.stringify(
      {
        range,
        generatedAt: new Date().toISOString(),
        posts: posts.map((post) => ({ ...post, date: formatDate(post.date) })),
        skipped,
      },
      null,
      2,
    ),
  );

  console.log(`已生成 ${path.relative(ROOT, path.join(outputDir, "report.md"))}`);
  console.log(`已生成 ${path.relative(ROOT, path.join(outputDir, "report.json"))}`);
  if (skipped.length > 0) {
    console.log(`跳过 ${skipped.length} 个文件:`);
    for (const item of skipped) console.log(`- ${item.file}: ${item.reason}`);
  }
}

if (import.meta.url === pathToFileURL(process.argv[1] ?? "").href) {
  await main();
}
它按顺序做四件事:读配置 → 找到每个平台的文件并识别平台 → 解析 CSV、归一化成统一字段 → 算中位数、标异常、写出 Markdown 和 JSON。
解析 CSV:别用 split(“,”)
后台导出经常出现下面几种情况,一行 split(",") 就会全错:
- 文件开头带 BOM。
- 换行是 CRLF。
- 标题里本身有逗号,被双引号包起来。
- 引号内的引号写成两个双引号转义。
所以脚本里有个最小的状态机解析器 parseCsv:逐字符扫描,遇到双引号就进入“引号内”模式,两个连续的双引号还原成一个,引号外的逗号才算分隔符。
引号内的换行也能保留:处于引号内时所有字符都直接写进字段,只有遇到不成对的引号才退出,所以标题跨行不会把一行拆成两行。
归一化:先变成同一种记录
不同平台的原始行读进来后,normalizeRow 把它们统一成同一种对象:曝光、互动、日期,字段名从此不再带平台方言。
数字字段要处理千分位和空值。后台导出偶尔会写成 1,024 或直接留空,Number("1,024") 会得到 NaN,所以 toNumber 先去掉逗号,再兜底成 0。
日期同理:有的导出是 2026/10/13,有的是 2026-10-13 19:20,统一转成 Date,失败就记为 null,不要让一条脏数据把整份周报搞崩。
用中位数找真正的异常
平均互动率会被一条爆款拉高,所以脚本用中位数做基准(median),并且只统计曝光 ≥ 100 的内容。
1.8 倍和 0.5 倍不是标准答案,只是第一版阈值。跑几周后你会知道自己账号的正常波动范围,再按实际分布调整。重点不是阈值多精确,而是每次都用同一套规则,这样异常才可比。
跑出周报
node review.mjs样例数据跑出来的结果大致是这样:
# 内容周报(2026-10-13 ~ 2026-10-19)

> 共 14 条内容,覆盖 3 个平台;曝光 125710,互动 12368,整体互动率 9.84%。

| 平台 | 条数 | 曝光 | 互动 | 互动率 |
| --- | ---: | ---: | ---: | ---: |
| 抖音 | 4 | 53900 | 5126 | 9.51% |
| 公众号 | 4 | 12610 | 843 | 6.69% |
| 小红书 | 6 | 59200 | 6399 | 10.81% |
| **合计** | 14 | 125710 | 12368 | 9.84% |

## 异常提醒

中位数互动率:7.52%(仅统计曝光 ≥ 100 的内容)

- 高于中位数 1.8 倍:**批量出封面后被限流?先检查这 4 点**(小红书,13.84%)

## 下周动作

- 把《批量出封面后被限流?先检查这 4 点》拆成 2–3 个变体,下周同一时段再发一次,验证是选题有效还是时间有效。
- 回看《复盘不是看数据,是决定下周写什么》的封面和前 3 秒:曝光有 1980,互动率只有 5.20%,优先改钩子而不是改选题。
脚本还会输出 out/report.json,里面保留每条内容的原始指标。把它按周存下来,以后想做月度趋势时不用重新导出。
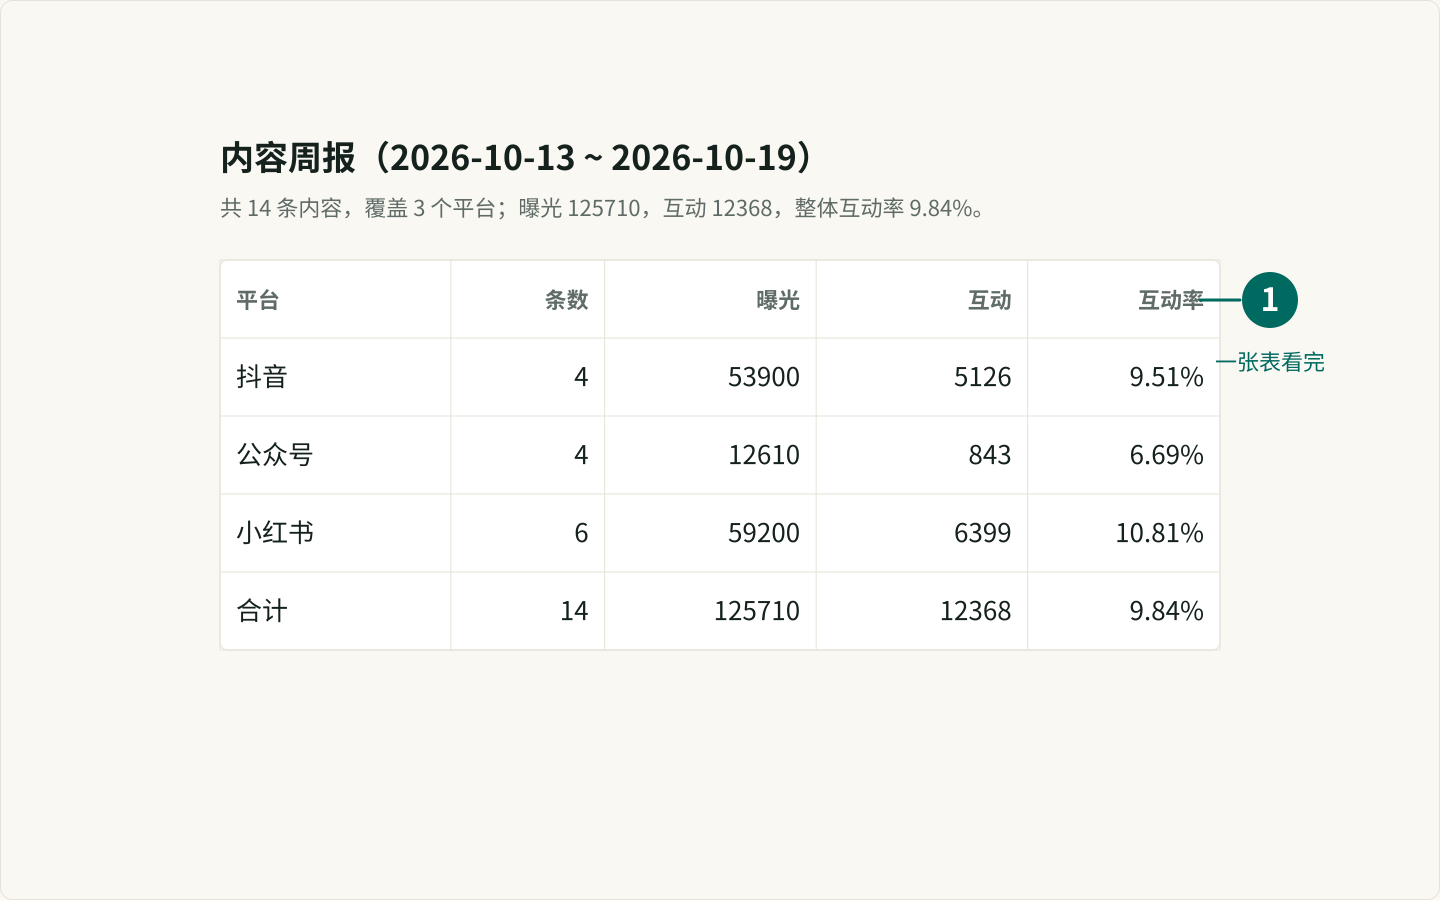
怎么读这份周报
先看平台,再看单条
如果小红书的互动率长期是公众号的两倍,问题可能不在内容,而在平台匹配度。先决定主战场,再优化单条内容,顺序反了会一直做无效努力。
高互动不等于可复制
一条内容互动率高,可能是选题好、封面好、发布时间好,也可能只是碰上了平台推荐。周报能指出“这条异常”,但不能告诉你原因。原因要你自己写下来,下一周用一条新内容验证。
低互动分两种
- 曝光高、互动低:分发没问题,钩子或内容不匹配。优先改开头。
- 曝光低、互动率正常:内容没问题,分发不够。优先改标题、封面和发布时间。
这两种情况的动作完全相反,所以不要把“数据差”当成一个结论。
进阶方向
第一版跑顺后,再考虑这些:
- 周对比:保留每周的
report.json,下周一并读取,输出“本周 vs 上周”。 - 发布时段:按
date的小时分组,看你的账号在什么时间互动率更高。 - 选题标签:在配置里加一列人工标签(教程、复盘、工具),看哪类内容稳定。
- 自动发布:把 Markdown 转成飞书文档或公众号草稿,省掉复制粘贴。
常见坑
1. 列名改了,脚本没报错
脚本只会跳过完全读不到标题的行。如果某个平台的列名变了,可能出现大量空标题被丢弃。跑完先看控制台有没有“跳过 N 个文件”,再打开 report.json 抽查几条。
2. 曝光为 0 的内容参与排名
第一版已经用 views >= 100 过滤。如果你的账号刚起步,把阈值降到 30 或 50,但要保证之后一直用同一个值。
3. 把导出文件提交进仓库
导出文件可能包含账号名、作品 ID 和流量来源。把 sample/ 换成真实数据前,先把输入目录加进 .gitignore;仓库里只留脱敏样例。
4. 复盘变成看数字
周报的价值不在表格,而在最后那段“下周动作”。如果一周过去没有执行任何一条动作,这份周报就只是一次数据搬运。
下一步读什么
多个平台的表先合并:两个表格合并。
表格本身乱码,先跑表格乱码怎么解决。
常见问题
为什么不直接看平台后台的数据看板?
单平台看板只能回答“这条好不好”,回答不了“哪个平台值得多投入”“同一选题在三个平台差多少”。把数据拉到一张表里,才能横向比较。
需要每天导出一次吗?
不需要。每周固定时间导出最近 7 天或 30 天的数据即可。频率太高反而会让复盘变成填表,坚持不下去。
互动率怎么算才合理?
这篇统一用(点赞 + 评论 + 收藏 + 分享)÷ 曝光。公众号把“在看”算收藏、“转发”算分享。关键是所有平台用同一个口径,否则横向比较没有意义。
导出的数据能提交到 Git 吗?
不要。后台导出文件可能带账号名、作品 ID 和流量结构。把输入目录和输出目录都加进 .gitignore,仓库里只保留脱敏样例。
每周一张复习表
每周分享一张实用复习表,不收钱不打扰,想走随时走
邮箱存在 Cloudflare KV 里,只用来发每周更新;任何时候写信到hello@genwozuo.com说「退订」就删掉。详见隐私政策。