两个表格合并成一张:保留来源列,不用手工复制
把多个 CSV 放进一个文件夹,脚本按列名取并集,自动加一列来源。默认只预览,确认后加 --write 输出 merged.csv,原文件不动。
30 秒速查
- 所有表格放一个文件夹,第一行是列名
- 预览:
node resources/merge-tables/merge.mjs data/- 确认后加
--write,输出data/merged.csv- 列名不同也能合,缺的列留空
这篇教程解决什么问题
三个平台各导一份表,想做一张总表;或者把 12 个月的表格拼成一年的数据。
手工复制有三个麻烦:列的顺序不一样,粘错位;多出来的列没地方放;粘完不知道哪一行来自哪个文件。数据一多,还会漏行。
这篇用一个脚本做三件事:
- 按列名合并,不按列的位置;
- 列名取并集,缺的列留空;
- 加一列
source_file,标出每行来自哪个文件。
默认只预览,确认后加 --write 才写盘。
准备两个样本
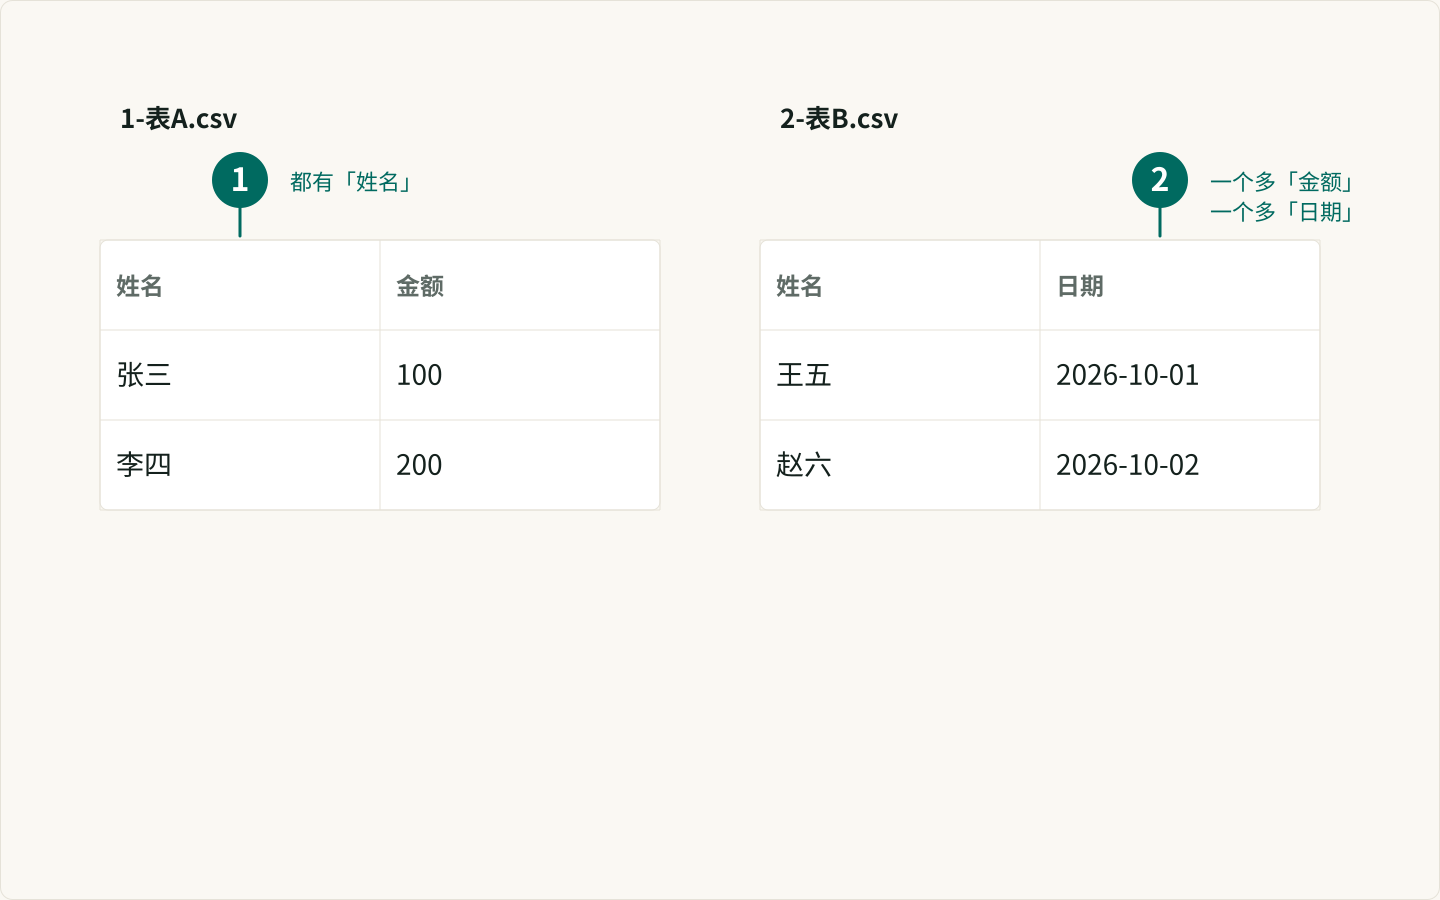
新建 data/,放两个表格。第一行是列名:
1-xiaohongshu.csv
标题,播放量,点赞
第一条,1200,86
第二条,980,42
2-douyin.csv
标题,播放量,评论
第三条,5300,31
"第五条,带逗号",800,9注意第二个文件有 评论、没有 点赞;最后一个标题里带逗号,所以用双引号包住。
合并规则
| 情况 | 怎么处理 |
|---|---|
| 列名相同 | 放在同一列 |
| 某个文件缺列 | 这一格留空 |
| 列顺序不同 | 按列名对齐,不看位置 |
| 来源 | 加 source_file 列,写文件名 |
输出统一用 UTF-8 带 BOM,Excel 双击打开中文正常;给程序读时加 --no-bom。
写脚本
把下面整段保存为 resources/merge-tables/merge.mjs:
import { readdir, readFile, stat, writeFile } from "node:fs/promises";
import path from "node:path";
import { pathToFileURL } from "node:url";

// 合并多个 CSV:列名取并集,多出来的列留空,并加一列 source_file。
// 默认只预览;加 --write 才写入 merged.csv。输入文件不会被改动。

export function parseCsv(text) {
  const rows = [];
  let row = [];
  let field = "";
  let quoted = false;

  for (let i = 0; i < text.length; i += 1) {
    const char = text[i];

    if (quoted) {
      if (char === '"') {
        if (text[i + 1] === '"') {
          field += '"';
          i += 1;
        } else {
          quoted = false;
        }
      } else {
        field += char;
      }
      continue;
    }

    if (char === '"') {
      quoted = true;
    } else if (char === ",") {
      row.push(field);
      field = "";
    } else if (char === "\n") {
      row.push(field);
      rows.push(row);
      row = [];
      field = "";
    } else if (char !== "\r") {
      field += char;
    }
  }

  if (field !== "" || row.length > 0) {
    row.push(field);
    rows.push(row);
  }

  return rows.filter((cells) => cells.some((cell) => cell !== ""));
}

export function toCsv(headers, rows) {
  const escape = (value) => {
    const text = value ?? "";
    return /[",\n\r]/.test(text) ? `"${text.replaceAll('"', '""')}"` : text;
  };

  return [
    headers.map(escape).join(","),
    ...rows.map((row) => headers.map((header) => escape(row[header])).join(",")),
  ].join("\n") + "\n";
}

export async function collectCsvFiles(target) {
  const info = await stat(target);
  if (!info.isDirectory()) return [target];

  const entries = await readdir(target, { withFileTypes: true });
  return entries
    .filter(
      (entry) =>
        entry.isFile() &&
        entry.name.toLowerCase().endsWith(".csv") &&
        entry.name.toLowerCase() !== "merged.csv" &&
        !entry.name.startsWith("."),
    )
    .sort((a, b) => a.name.localeCompare(b.name))
    .map((entry) => path.join(target, entry.name));
}

export async function mergeFiles(files) {
  const headers = [];
  const rows = [];

  for (const file of files) {
    const text = (await readFile(file, "utf8")).replace(/^\uFEFF/, "");
    const table = parseCsv(text);
    if (table.length === 0) continue;

    const [head, ...body] = table;
    for (const name of head) {
      if (name !== "source_file" && !headers.includes(name)) headers.push(name);
    }

    for (const cells of body) {
      const row = {};
      head.forEach((name, index) => {
        row[name] = cells[index] ?? "";
      });
      row.source_file = path.basename(file);
      rows.push(row);
    }
  }

  headers.push("source_file");
  return { headers, rows, files };
}

const isDirectRun =
  process.argv[1] &&
  pathToFileURL(path.resolve(process.argv[1])).href === import.meta.url;

if (isDirectRun) {
  const args = process.argv.slice(2);
  const write = args.includes("--write");
  const bom = !args.includes("--no-bom");
  const target = args.find((arg) => !arg.startsWith("--")) ?? "data";

  try {
    const files = await collectCsvFiles(target);

    if (files.length === 0) {
      console.error("没有找到 CSV 文件。");
      process.exitCode = 1;
    } else {
      const merged = await mergeFiles(files);
      const isDir = (await stat(target)).isDirectory();
      const outFile = path.join(isDir ? target : path.dirname(target), "merged.csv");

      console.log(`读取 ${files.length} 个文件,共 ${merged.rows.length} 行`);
      console.log(`列:${merged.headers.join(", ")}`);

      if (write) {
        const text = toCsv(merged.headers, merged.rows);
        await writeFile(outFile, (bom ? "\uFEFF" : "") + text, "utf8");
        console.log(`已写入:${outFile}`);
      } else {
        console.log(`[预览] 合并后写入:${outFile}(加 --write 执行)`);
      }
    }
  } catch (error) {
    if (error.code === "ENOENT" || error.code === "ENOTDIR") {
      console.error(`打不开路径:${target}`);
      process.exitCode = 1;
    } else {
      throw error;
    }
  }
}
读代码时抓住三件事:
parseCsv按 CSV 规则处理引号,单元格里的逗号不会把列拆开。mergeFiles先收集所有列名,再逐行按列名填值。- 默认
write=false,只算不写;--write才生成merged.csv。
先预览
node resources/merge-tables/merge.mjs data真实输出:
读取 2 个文件,共 4 行
列:标题, 播放量, 点赞, 评论, source_file
[预览] 合并后写入:data/merged.csv(加 --write 执行)
预览只读文件,不会生成 merged.csv。
写入
node resources/merge-tables/merge.mjs data --write读取 2 个文件,共 4 行
列:标题, 播放量, 点赞, 评论, source_file
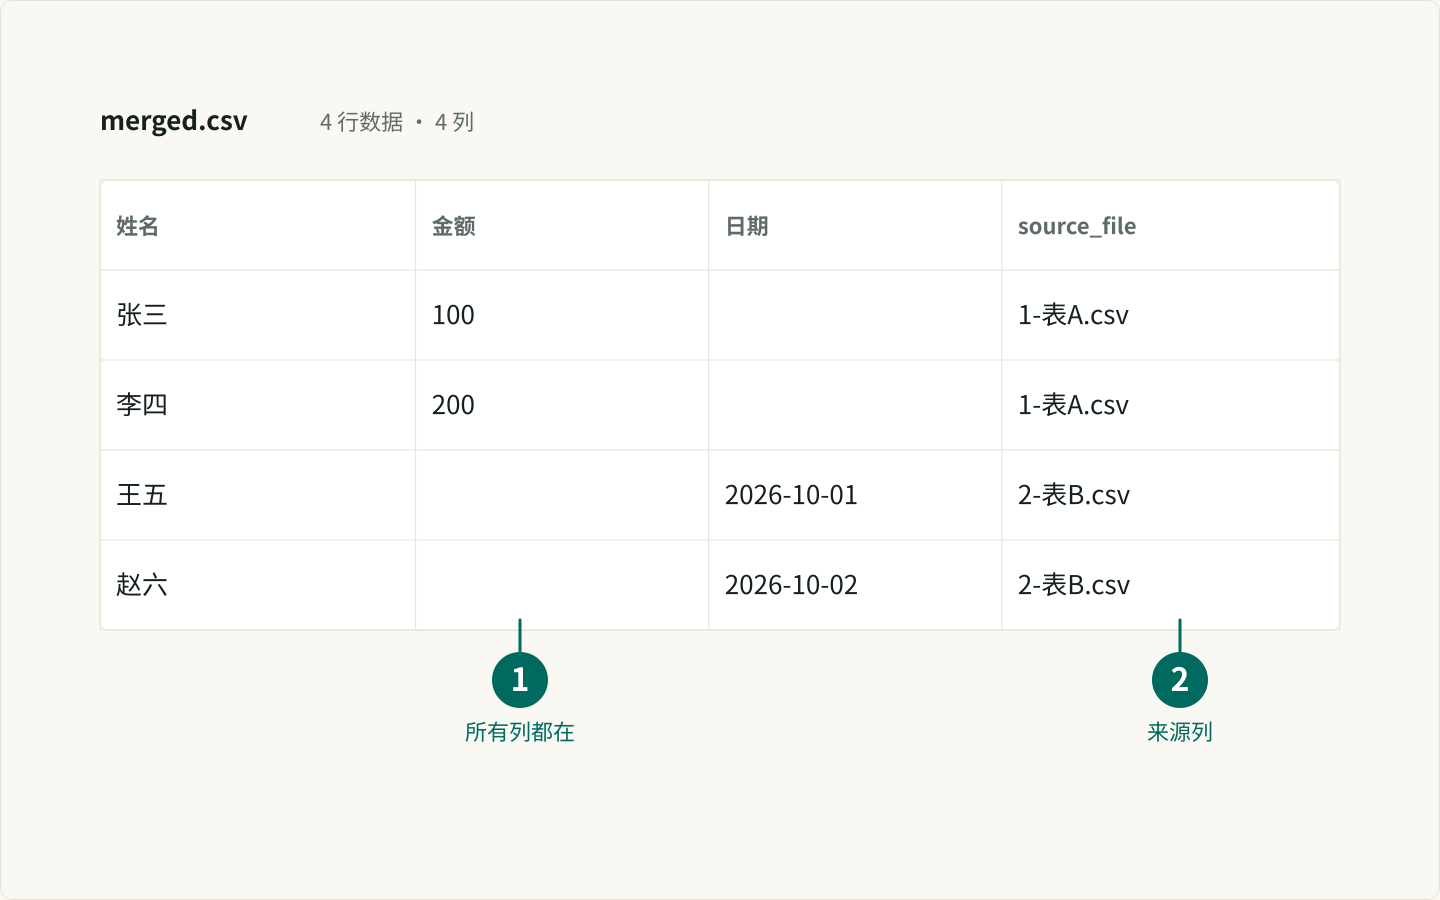
已写入:data/merged.csv打开 data/merged.csv:
标题,播放量,点赞,评论,source_file
第一条,1200,86,,1-xiaohongshu.csv
第二条,980,42,,1-xiaohongshu.csv
第三条,5300,,31,2-douyin.csv
"第五条,带逗号",800,,9,2-douyin.csv两个文件缺的列是空的,source_file 能看出每行来自哪张表。
合并后检查
- 行数等于几份表的数据行之和,没有漏表。
- 每一行的
source_file都能对上原文件。 - 用 Excel 打开,中文和带逗号的标题没有错列。
- 如果某一列全是空,说明两份表的列名没对上,回去统一列名。
列的顺序按第一次出现的顺序排;想固定顺序,就在脚本里改 headers 的顺序。
常见坑
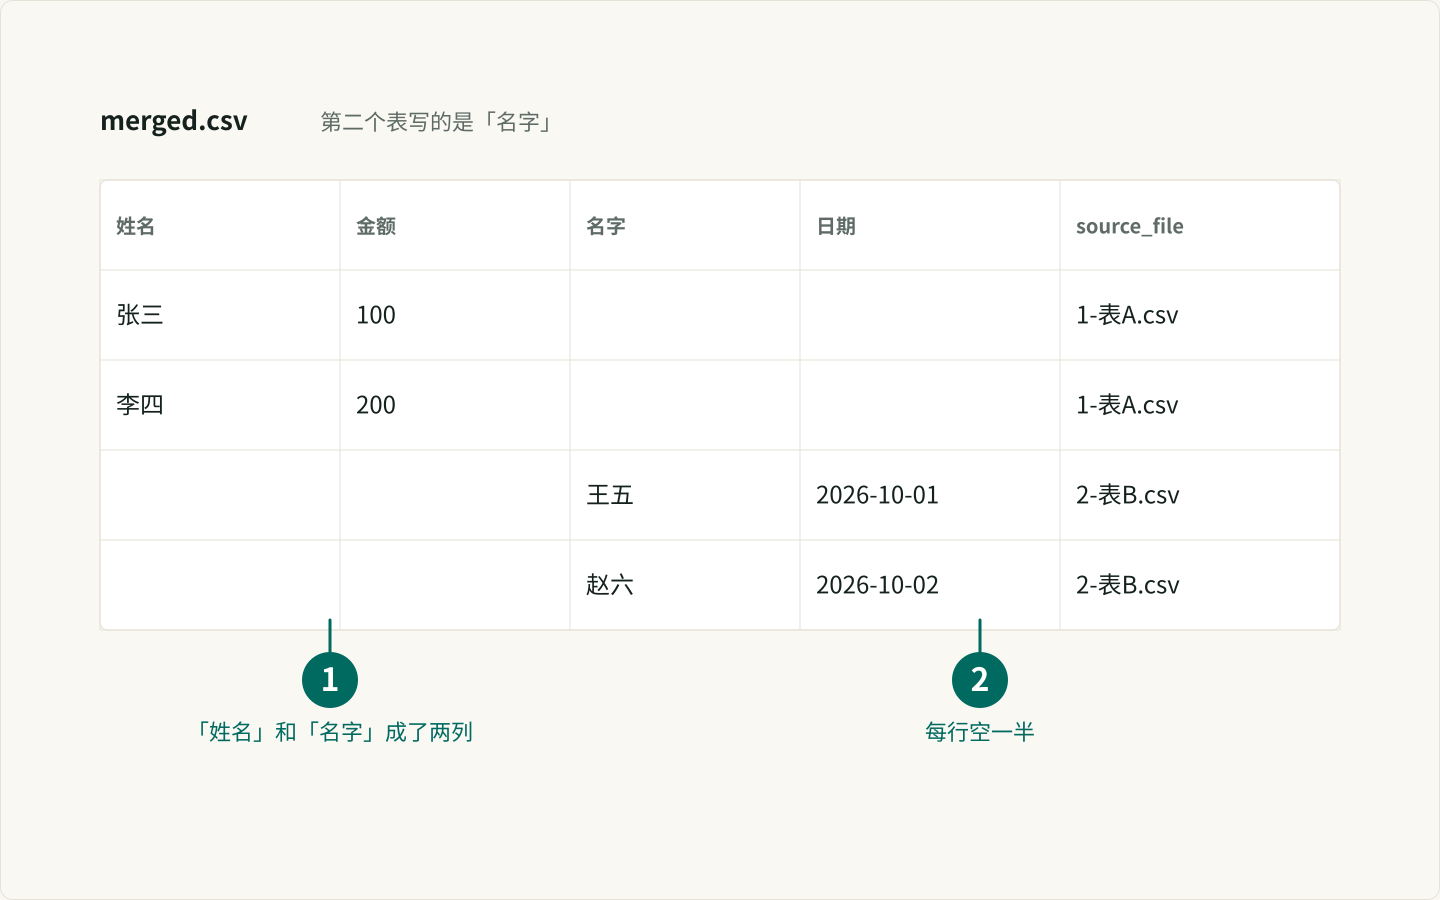
1. 列名不一致
播放量 和 播放数 会被当成两列。合并前统一列名,或先用表格软件的查找替换改好。
2. 表格编码不同
脚本按 UTF-8 读。GBK 的表格先用 fix-csv 转一次,再合并;否则中文会变乱码。
3. 第一个文件没有表头
脚本把第一行当列名。如果某张表是从第二行开始的数据,先补一行表头。
4. 输出文件已存在
--write 会覆盖同目录的 merged.csv。想保留旧结果,先改名或换一个文件夹。
下一步读什么
表格合完,下一步是把它变成结论:每周数据复盘 会读多个平台的表,统一字段、算互动率、出周报。
这篇也属于从 0 开始:第一台自动化工作台的文件处理环节。
常见问题
两个表格的列名不一样,能合吗?
能。脚本按列名取并集,某个文件没有的列就留空;最后多一列 source_file,记录这一行来自哪个文件。
会覆盖原来的表格吗?
不会。它只读输入文件,输出固定叫 merged.csv;加 --write 才写盘,之前只打印预览。
单元格里有逗号或换行怎么办?
用双引号包住整个单元格,脚本按 CSV 规则解析;输出时也会自动加引号,Excel 打开不会错列。
表格是 GBK,打开是乱码?
先跑 fix-csv 转成 UTF-8,再合并。合并脚本按 UTF-8 读,不猜编码,避免越合越乱。
每周一张复习表
每周分享一张实用复习表,不收钱不打扰,想走随时走
邮箱存在 Cloudflare KV 里,只用来发每周更新;任何时候写信到hello@genwozuo.com说「退订」就删掉。详见隐私政策。